اگر در گزارش Page Indexing سرچ کنسول با وضعیتهای Discovered – currently not indexed و Crawled – currently not indexed روبهرو شدهاید، احتمالاً اولین سؤال شما این است: «بالاخره مشکل از کجاست؟ گوگل صفحه را دیده یا نه؟ باید Request Indexing بزنم یا محتوا را اصلاح کنم؟»
این دو وضعیت شبیه به هم به نظر میرسند، اما معنی یکسانی ندارند. در وضعیت Discovered، گوگل URL را میشناسد، اما هنوز محتوای صفحه را Crawl نکرده است. در وضعیت Crawled، گوگل صفحه را Crawl کرده، اما فعلاً تصمیم نگرفته آن را وارد ایندکس کند.
همین تفاوت کوچک مسیر عیبیابی را کاملاً عوض میکند. اگر صفحه در وضعیت Discovered مانده باشد، باید بیشتر سراغ کشف URL، لینک داخلی، Sitemap، اولویت صفحه، crawl demand و ظرفیت Crawl بروید. اما اگر صفحه Crawled شده و هنوز ایندکس نشده، احتمالاً باید کیفیت محتوا، تکراریبودن، Canonical، Soft 404، Render و ارزش مستقل صفحه را بررسی کنید.

تفاوت سریع Discovered و Crawled در سرچ کنسول
برای شروع، تفاوت این دو وضعیت را خیلی ساده ببینیم:
| وضعیت در سرچ کنسول | معنی ساده | مرحلهای که مشکل در آن رخ داده | اولویت بررسی |
|---|---|---|---|
| Discovered – currently not indexed | گوگل URL را میشناسد، اما هنوز آن را Crawl نکرده است. | قبل از Crawl | لینک داخلی، Sitemap، اولویت URL، کیفیت کلی سایت، Crawl Budget |
| Crawled – currently not indexed | گوگل URL را Crawl کرده، اما فعلاً آن را وارد ایندکس نکرده است. | بعد از Crawl و قبل از Index | کیفیت محتوا، Duplicate، Canonical، Soft 404، Rendering، ارزش مستقل صفحه |
پس سؤال اصلی این نیست که «کدام وضعیت بدتر است؟» سؤال بهتر این است: «در کدام مرحله از مسیر ایندکسشدن گیر کردهایم؟»
Discovered – currently not indexed یعنی چه؟
وضعیت Discovered – currently not indexed یعنی گوگل از وجود URL خبر دارد، اما هنوز آن را Crawl نکرده یا پردازش کامل آن را انجام نداده است. به زبان ساده، گوگل آدرس صفحه را در لیست خود دیده، اما هنوز وارد صفحه نشده تا محتوای واقعی آن را بررسی کند.
گوگل ممکن است URL را از راههای مختلفی کشف کرده باشد:
- Sitemap XML
- لینک داخلی از صفحات دیگر سایت
- لینک خارجی از سایتهای دیگر
- ریدایرکت از یک URL قدیمی
- URLهایی که قبلاً شناخته شدهاند
- درخواست ایندکس از URL Inspection
اما کشف URL به معنی Crawlشدن یا ایندکسشدن نیست. Sitemap فقط به گوگل کمک میکند URLهای مهم را بشناسد؛ اما تضمین نمیکند که همه URLها Crawl یا Index شوند.
آیا Discovered همیشه مشکل فنی است؟
نه. خیلی وقتها Discovered به معنی خطای مستقیم در همان صفحه نیست. ممکن است صفحه از نظر فنی سالم باشد، اما گوگل هنوز آن را در اولویت Crawl قرار نداده باشد. این موضوع معمولاً به ترکیبی از چند عامل برمیگردد:
- اولویت پایین URL در معماری سایت
- لینک داخلی ضعیف یا نبود لینک داخلی
- کیفیت پایین یا تکراریبودن بخش زیادی از سایت
- وجود تعداد زیادی URL کمارزش در سایت
- مشکلات سرور، کندی پاسخ یا خطاهای 5xx
- Sitemap شلوغ، قدیمی یا پر از URLهای غیرقابلایندکس
- تازه منتشرشدن صفحه و نیاز به زمان بیشتر
اگر فقط چند URL تازهمنتشرشده در این وضعیت هستند، معمولاً جای نگرانی فوری نیست. اما اگر تعداد زیادی از صفحات مهم سایت برای مدت طولانی در Discovered ماندهاند، باید ساختار سایت و کیفیت سیگنالهای Crawl را جدیتر بررسی کنید.
دلایل رایج Discovered – currently not indexed
۱. صفحه لینک داخلی کافی ندارد
اگر یک صفحه فقط در Sitemap وجود داشته باشد و از بخشهای مهم سایت لینک نگرفته باشد، گوگل ممکن است آن را کماهمیتتر تلقی کند. صفحات مهم باید از صفحات مرتبط، دستهبندیها، مقالات مادر یا منوهای قابلخزش لینک داخلی بگیرند.
یک صفحه یتیم یا Orphan Page ممکن است کشف شود، اما Crawl آن عقب بیفتد؛ چون جایگاهش در معماری سایت روشن نیست.
۲. Sitemap تمیز نیست
اگر Sitemap شما پر از URLهای 404، ریدایرکت، noindex، پارامتری، تکراری یا کمارزش باشد، گوگل سیگنال واضحی از صفحات مهم دریافت نمیکند. Sitemap باید فقط URLهایی را معرفی کند که واقعاً ارزش Crawl و Index دارند.
۳. سایت URLهای کمارزش زیادی تولید میکند
در فروشگاهها، مارکتپلیسها و سایتهای بزرگ، فیلترها و پارامترها میتوانند هزاران URL بسازند. اگر این URLها در لینک داخلی یا Sitemap قابلدسترسی باشند، بخشی از توجه Googlebot صرف صفحاتی میشود که ارزش ایندکس ندارند.
نمونههایی از URLهای کمارزش:
- صفحات فیلتر بدون تقاضای جستوجو
- URLهای مرتبسازی مثل
?sort=price - صفحات جستوجوی داخلی
- صفحات Tag خالی یا بسیار ضعیف
- نسخههای پارامتری تکراری
۴. سرور کند یا ناپایدار است
اگر سرور سایت در زمان Crawl کند باشد یا خطاهای زیادی بدهد، گوگل ممکن است سرعت Crawl را کاهش دهد. در نتیجه URLهای جدید دیرتر Crawl میشوند و بیشتر در وضعیت Discovered باقی میمانند.
برای بررسی این موضوع باید گزارش Crawl Stats را در سرچ کنسول ببینید و به Average Response Time، خطاهای Host، خطاهای 5xx و روند درخواستهای Crawl توجه کنید.
۵. صفحه تازه منتشر شده است
اگر صفحه را همین امروز یا چند روز قبل منتشر کردهاید، Discovered بودن آن میتواند طبیعی باشد. Request Indexing میتواند درخواست بررسی را سریعتر به گوگل منتقل کند، اما تضمین ایندکس فوری نیست.
Crawled – currently not indexed یعنی چه؟
وضعیت Crawled – currently not indexed یعنی گوگل صفحه را Crawl کرده، اما فعلاً آن را وارد ایندکس نکرده است. اینجا تفاوت مهمی با Discovered داریم: گوگل دیگر فقط URL را نمیشناسد؛ حداقل یک بار وارد صفحه شده و پاسخ آن را دریافت کرده است.
پس اگر صفحه در وضعیت Crawled قرار دارد، معمولاً مشکل اصلی این نیست که گوگل نمیتواند به URL برسد. مشکل بیشتر در این مرحلههاست:
- آیا محتوای صفحه ارزش مستقل دارد؟
- آیا صفحه با URLهای دیگر تکراری است؟
- آیا Canonical درست تنظیم شده؟
- آیا صفحه شبیه Soft 404 تشخیص داده شده؟
- آیا محتوای اصلی پس از Rendering قابلمشاهده است؟
- آیا صفحه به intent مشخصی پاسخ میدهد؟
در بسیاری از موارد، Crawled – currently not indexed یعنی گوگل صفحه را دیده، اما آن را برای نگهداری در ایندکس به اندازه کافی ارزشمند یا متمایز تشخیص نداده است.
دلایل رایج Crawled – currently not indexed
۱. محتوا ارزش مستقل کافی ندارد
اگر صفحه کوتاه، سطحی، تکراری یا بدون پاسخ مشخص به نیاز کاربر باشد، ممکن است Crawl شود اما ایندکس نشود. این اتفاق بهخصوص در صفحات زیر رایج است:
- صفحات محصول با توضیحات بسیار کم
- مقالات کوتاه و عمومی بدون زاویه اختصاصی
- صفحات شهر با متن تقریباً یکسان
- صفحات دستهبندی بدون توضیح، محصول کافی یا ارزش جستوجویی
- صفحات تولیدشده خودکار بدون ویرایش انسانی
۲. صفحه Duplicate یا بسیار مشابه است
اگر چند URL محتوای بسیار مشابه داشته باشند، گوگل ممکن است فقط یکی از آنها را بهعنوان نسخه اصلی نگه دارد. در این حالت، URLهای دیگر میتوانند در وضعیت Crawled – currently not indexed قرار بگیرند.
نمونههای رایج:
- نسخههای پارامتری یک صفحه
- صفحات محصول با توضیحات کپیشده از تولیدکننده
- صفحات دستهبندی با محتوای بسیار نزدیک
- مقالات تکراری با تغییرات جزئی در عنوان
۳. Canonical با انتظار شما فرق دارد
گاهی شما انتظار دارید یک URL ایندکس شود، اما گوگل نسخه دیگری را بهعنوان Canonical انتخاب میکند. در URL Inspection باید دو بخش را بررسی کنید:
- User-declared canonical
- Google-selected canonical
اگر این دو متفاوت باشند، یعنی سیگنالهای سایت شما برای گوگل شفاف نیستند یا محتوای صفحه به نسخه دیگری بسیار نزدیک است.
۴. صفحه شبیه Soft 404 است
Soft 404 صفحهای است که از نظر سرور پاسخ 200 میدهد، اما محتوای آن شبیه صفحه خالی، صفحه خطا یا «موردی یافت نشد» است. اگر صفحهای محصول ندارد، مقاله واقعی ندارد، یا محتوای اصلی آن برای کاربر ارزشمند نیست، ممکن است در این دسته قرار بگیرد.
۵. Rendering مشکل دارد
گاهی گوگل صفحه را Fetch میکند، اما در مرحله Rendering محتوای اصلی را نمیبیند. این مشکل بیشتر در سایتهای JavaScript محور دیده میشود؛ مخصوصاً وقتی محتوا بعد از اجرای JS یا دریافت پاسخ API ساخته میشود.
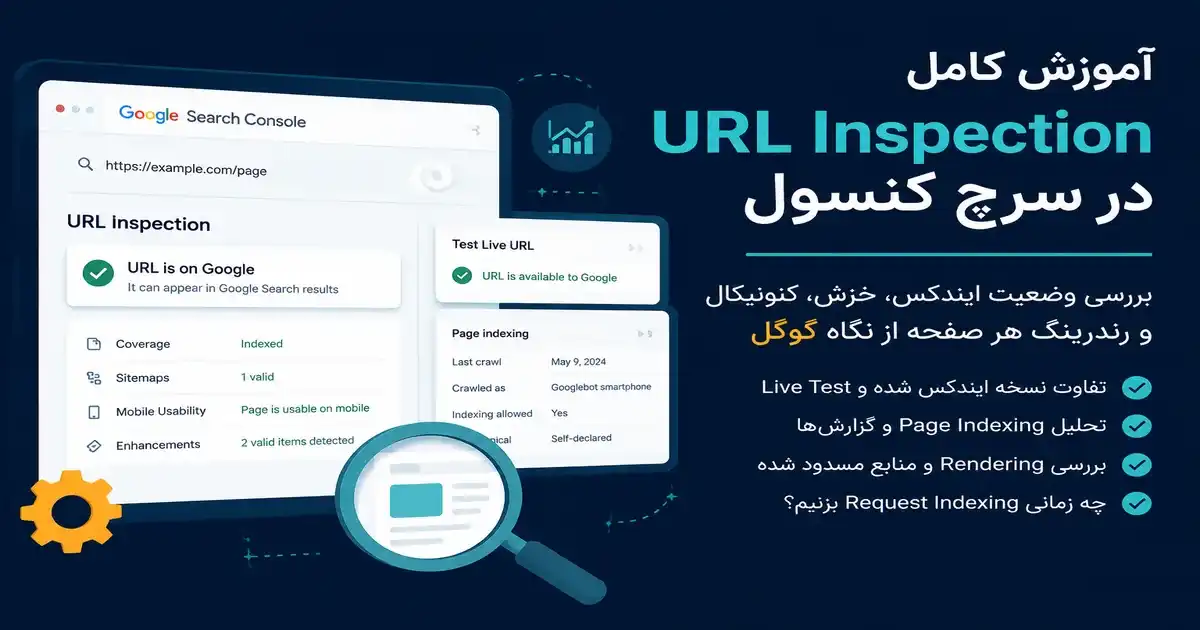
برای بررسی این حالت، در URL Inspection از Test Live URL استفاده کنید، سپس View Tested Page را باز کنید و Screenshot و Rendered HTML را بررسی کنید. اگر محتوای اصلی در Screenshot یا HTML رندرشده دیده نمیشود، مسئله فقط ایندکس نیست؛ باید مشکل Rendering را حل کنید.
چطور بفهمیم کدام وضعیت مهمتر است؟
همه URLهای ایندکسنشده ارزش پیگیری یکسان ندارند. بعضی URLها اصلاً نباید ایندکس شوند؛ مثل صفحات فیلتر، پنل کاربری، نتایج جستوجوی داخلی یا صفحات noindex. بنابراین قبل از شروع اصلاح، URLها را دستهبندی کنید.
این سؤالها را بپرسید:
- آیا این URL باید در گوگل دیده شود؟
- آیا صفحه برای کسبوکار مهم است؟
- آیا صفحه کلیک یا ایمپرشن داشته یا میتواند داشته باشد؟
- آیا صفحه در Sitemap قرار دارد؟
- آیا از صفحات مهم لینک داخلی گرفته است؟
- آیا محتوای آن با صفحات دیگر فرق معنادار دارد؟
- آیا Google-selected canonical همان URL مورد انتظار شماست؟
اگر URL مهم نیست، لازم نیست برای ایندکسکردن آن انرژی بگذارید. اما اگر URL صفحه محصول، مقاله اصلی، دستهبندی مهم یا صفحه خدماتی است، باید وضعیت آن را جدی بررسی کنید.
مسیر بررسی Discovered – currently not indexed
اگر URLهای مهم سایت در وضعیت Discovered هستند، این مسیر را دنبال کنید:
- بررسی کنید URL داخل Sitemap هست یا نه.
- مطمئن شوید URL پاسخ
200میدهد و ریدایرکت یا خطای سرور ندارد. - بررسی کنید صفحه از چند صفحه مرتبط لینک داخلی گرفته است.
- عمق کلیک صفحه را بررسی کنید؛ صفحه مهم نباید در عمق بسیار زیاد باشد.
- Sitemap را از URLهای noindex، 404، ریدایرکت و پارامتری پاکسازی کنید.
- در Crawl Stats، خطاهای Host و افزایش زمان پاسخ سرور را بررسی کنید.
- اگر صفحه تازه منتشر شده، چند روز زمان بدهید و در صورت نیاز Request Indexing بزنید.
در Discovered، تمرکز اصلی باید روی این باشد که چرا گوگل هنوز صفحه را در اولویت Crawl قرار نداده است.
مسیر بررسی Crawled – currently not indexed
اگر URLهای مهم سایت در وضعیت Crawled هستند، این مسیر را دنبال کنید:
- URL را در URL Inspection بررسی کنید.
- Google-selected canonical را با URL مورد انتظار خودتان مقایسه کنید.
- Screenshot و Rendered HTML را بررسی کنید تا مطمئن شوید محتوای اصلی دیده میشود.
- صفحه را از نظر محتوای تکراری یا بسیار مشابه بررسی کنید.
- مطمئن شوید صفحه شبیه Soft 404 نیست.
- محتوا را با intent کاربر مقایسه کنید؛ آیا پاسخ کامل و مستقل میدهد؟
- لینک داخلی به صفحه را تقویت کنید.
- بعد از اصلاح، Test Live URL و سپس Request Indexing را اجرا کنید.
در Crawled، تمرکز اصلی باید روی این باشد که چرا گوگل بعد از دیدن صفحه، آن را برای ایندکس انتخاب نکرده است.
اشتباهات رایج هنگام دیدن این دو وضعیت
Request Indexing زدن بدون اصلاح مشکل
Request Indexing راهحل جادویی نیست. اگر صفحه کیفیت کافی ندارد، Canonical اشتباه دارد، محتوای اصلی Render نمیشود یا لینک داخلی ضعیف است، درخواست ایندکس بهتنهایی مشکل را حل نمیکند.
نگرانی درباره همه URLهای Not indexed
همه URLهای Not indexed مشکل نیستند. بعضی صفحات عمداً نباید ایندکس شوند. هدف شما نباید ایندکسکردن همه URLها باشد؛ هدف باید ایندکسشدن URLهای مهم و قابلارزش باشد.
نادیدهگرفتن کیفیت محتوا
وقتی صفحه Crawled شده اما ایندکس نشده، خیلیها فقط دنبال مشکل فنی میگردند. در حالی که در بسیاری از موارد، مسئله اصلی ارزش محتوا، تمایز صفحه و پاسخ به intent کاربر است.
بررسینکردن نسخه رندرشده
در سایتهای مدرن، فقط دیدن کد وضعیت 200 کافی نیست. باید مطمئن شوید Googlebot در نسخه رندرشده هم محتوای اصلی، لینکها و عناصر مهم صفحه را میبیند.
چطور پالت در تحلیل این وضعیتها کمک میکند؟
سرچ کنسول ابزار اصلی بررسی وضعیت ایندکس است، اما وقتی تعداد URLها زیاد میشود، تحلیل دستی سخت و زمانبر میشود. مشکل فقط این نیست که چند URL در وضعیت Discovered یا Crawled قرار دارند؛ مشکل این است که بفهمید کدام URLها واقعاً مهماند و اول باید سراغ کدام گروه بروید.
پلاگین تحلیل سرچ کنسول پالت کمک میکند دادههای خام سرچ کنسول را به تصمیم عملی تبدیل کنید. بهجای اینکه فقط یک لیست بلند از URLهای ایندکسنشده داشته باشید، میتوانید URLها را بر اساس اهمیت، وضعیت، کلیک، ایمپرشن و نوع مشکل اولویتبندی کنید.
برای مثال، اگر ۳۰۰ URL در وضعیت Crawled – currently not indexed دارید، همه آنها ارزش یکسان ندارند. صفحهای که ایمپرشن داشته، در Sitemap است و صفحه خدماتی مهمی محسوب میشود، باید زودتر از یک Tag کمارزش بررسی شود.
چکلیست سریع تصمیمگیری
| اگر این وضعیت را دیدید | اول این موارد را بررسی کنید | اقدام پیشنهادی |
|---|---|---|
| Discovered – currently not indexed | Sitemap، لینک داخلی، اولویت URL، Crawl Stats، کیفیت کلی سایت | تقویت لینک داخلی، پاکسازی Sitemap، کاهش URLهای کمارزش، بررسی سرور |
| Crawled – currently not indexed | کیفیت محتوا، Canonical، Duplicate، Soft 404، Rendering | بهبود محتوا، رفع تکرار، بررسی URL Inspection، اصلاح Render و Canonical |
پرسشهای رایج
آیا Discovered – currently not indexed یعنی گوگل صفحه را دیده است؟
گوگل URL را شناخته، اما معمولاً هنوز محتوای صفحه را Crawl نکرده است. بنابراین نمیتوان گفت صفحه از نظر محتوا بررسی شده؛ فقط URL برای گوگل شناخته شده است.
آیا Crawled – currently not indexed یعنی صفحه مشکل فنی دارد؟
نه همیشه. ممکن است صفحه از نظر فنی قابلدسترسی باشد، اما گوگل آن را به دلیل کیفیت پایین، شباهت زیاد به صفحات دیگر، Canonical متفاوت یا ارزش مستقل ناکافی وارد ایندکس نکند.
آیا باید همه URLهای Discovered و Crawled را اصلاح کنیم؟
نه. فقط URLهایی را جدی بررسی کنید که باید در گوگل دیده شوند و برای کسبوکار یا استراتژی محتوایی شما مهم هستند.
آیا Request Indexing مشکل را حل میکند؟
Request Indexing فقط درخواست بررسی مجدد است. اگر مشکل اصلی صفحه حل نشده باشد، درخواست ایندکس معمولاً نتیجه پایداری ایجاد نمیکند.
کدام وضعیت نگرانکنندهتر است؟
بستگی به نوع URL دارد. برای صفحات تازه، Discovered میتواند طبیعی باشد. اما اگر صفحات مهم مدت طولانی در Discovered یا Crawled بمانند، باید علت را بررسی کنید. در Crawled معمولاً بررسی کیفیت محتوا و Canonical اهمیت بیشتری دارد.
جمعبندی
تفاوت Discovered و Crawled در سرچ کنسول، تفاوت بین دو مرحله متفاوت از مسیر ایندکسشدن است.
Discovered – currently not indexed یعنی گوگل URL را میشناسد، اما هنوز آن را Crawl نکرده یا پردازش کامل آن انجام نشده است. در این حالت باید بیشتر روی لینک داخلی، Sitemap، Crawl Budget، کیفیت کلی سایت و اولویت URL تمرکز کنید.
Crawled – currently not indexed یعنی گوگل صفحه را Crawl کرده، اما فعلاً آن را وارد ایندکس نکرده است. در این حالت باید کیفیت محتوا، تکراریبودن، Canonical، Soft 404، Rendering و ارزش مستقل صفحه را بررسی کنید.
هدف شما نباید ایندکسشدن همه URLها باشد؛ هدف درست این است که صفحات مهم، قابلاعتماد و ارزشمند سایت بهدرستی کشف، Crawl، Render و Index شوند. برای این کار، سرچ کنسول نقطه شروع است؛ اما برای اولویتبندی URLها در مقیاس بزرگ، پالت میتواند تحلیل را سریعتر و عملیتر کند.