ایندکس نشدن صفحات سایت یکی از رایجترین و در عین حال گیجکنندهترین مشکلاتی است که در Google Search Console دیده میشود. ممکن است یک صفحه تازه منتشر کرده باشید، در Sitemap هم وجود داشته باشد، حتی با URL Inspection درخواست ایندکس داده باشید، اما بعد از چند روز همچنان در نتایج گوگل دیده نشود.
مشکل اینجاست که «ایندکس نشدن» فقط یک علت ندارد. گاهی گوگل هنوز URL را کشف نکرده است. گاهی URL را میشناسد اما Crawl نکرده. گاهی Crawl انجام شده، اما صفحه به دلیل noindex، Canonical، محتوای تکراری، Soft 404، مشکل Rendering یا ضعف کیفیت محتوا وارد ایندکس نمیشود.
در این مقاله مسیر بررسی ایندکس نشدن صفحات را مرحلهبهمرحله جلو میبریم. هدف این نیست که همه URLهای سایت را به هر قیمتی ایندکس کنیم؛ هدف این است که بفهمیم کدام صفحات واقعاً باید در گوگل باشند و چرا بعضی از آنها وارد ایندکس نشدهاند.

ایندکس نشدن صفحه یعنی چه؟
وقتی میگوییم یک صفحه ایندکس نشده، یعنی گوگل اطلاعات آن صفحه را در ایندکس خود نگه نداشته یا فعلاً از آن برای نمایش در نتایج جستوجو استفاده نمیکند. این موضوع با رتبه نگرفتن فرق دارد.
یک صفحه ممکن است:
- کشف نشده باشد؛
- کشف شده اما Crawl نشده باشد؛
- Crawl شده اما Index نشده باشد؛
- Index شده اما برای عبارت موردنظر رتبه نگیرد؛
- بهجای خودش، URL دیگری بهعنوان Canonical در نتایج استفاده شود.
بنابراین قبل از هر اقدامی باید مشخص کنید مشکل دقیقاً در کدام مرحله رخ داده است: Discovery، Crawl، Rendering، Indexing یا Ranking.
قبل از عیبیابی، مطمئن شوید صفحه واقعاً ایندکس نشده است
گاهی صفحه در گوگل وجود دارد، اما برای عبارت موردنظر شما رتبه نمیگیرد. این با ایندکس نشدن متفاوت است. برای بررسی دقیقتر، از این مسیرها استفاده کنید:
- URL را در ابزار URL Inspection سرچ کنسول بررسی کنید.
- وضعیت صفحه را در گزارش Page Indexing ببینید.
- جستوجوی مستقیم با آدرس صفحه یا دستور
site:را فقط بهعنوان نشانه کمکی در نظر بگیرید، نه معیار نهایی. - بررسی کنید آیا Google-selected canonical همان URL موردنظر شماست یا نه.
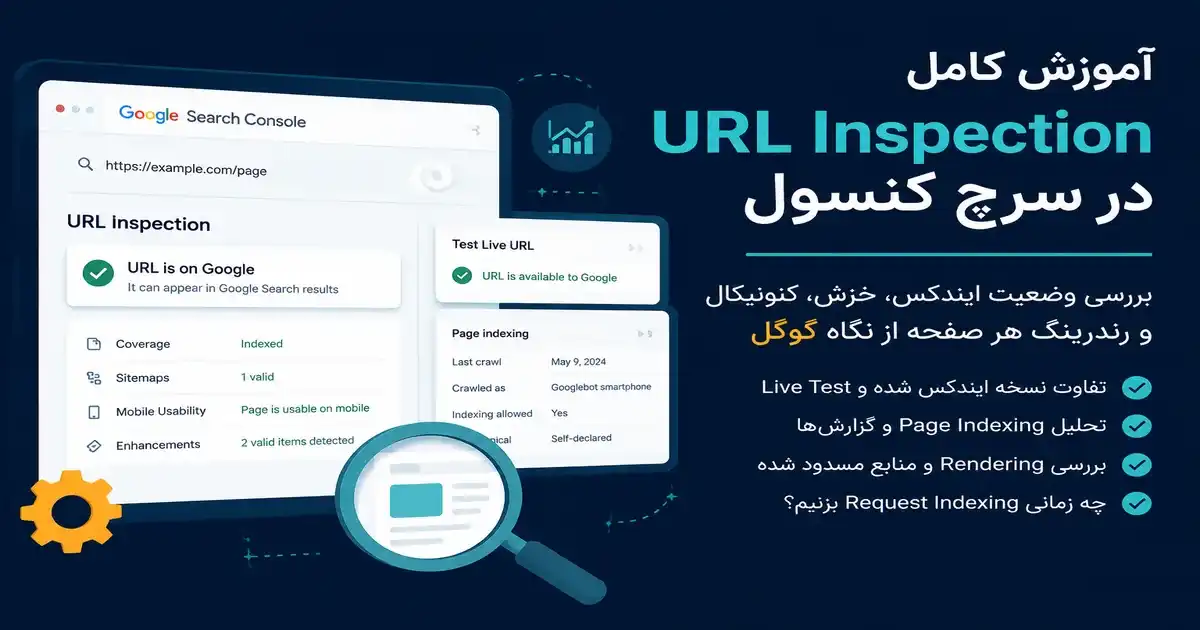
معتبرترین نقطه شروع برای یک URL مشخص، ابزار URL Inspection است. این ابزار نشان میدهد گوگل چه چیزی از صفحه میداند، آخرین Crawl چه زمانی بوده، Crawl allowed هست یا نه، Page fetch چه وضعیتی دارد و Canonical انتخابشده توسط گوگل کدام URL است.
دلایل رایج ایندکس نشدن صفحات سایت
در جدول زیر، رایجترین دلایل ایندکس نشدن صفحات را بهصورت خلاصه میبینید:
| دلیل احتمالی | نشانه در سرچ کنسول | اولویت بررسی |
|---|---|---|
| URL هنوز کشف نشده | در گزارشها دیده نمیشود یا داده کافی ندارد | لینک داخلی، Sitemap، معماری سایت |
| کشف شده اما Crawl نشده | Discovered – currently not indexed | اولویت URL، Crawl Budget، کیفیت سیگنالها |
| Crawl شده اما ایندکس نشده | Crawled – currently not indexed | محتوا، Canonical، Duplicate، Rendering |
| noindex وجود دارد | Excluded by noindex tag | Meta Robots، X-Robots-Tag، تنظیمات CMS |
| Canonical به URL دیگر است | Alternate page یا Google-selected canonical متفاوت | Canonical، لینک داخلی، Sitemap، محتوای تکراری |
| صفحه Soft 404 است | Soft 404 | ارزش محتوا، وضعیت صفحه، پاسخ HTTP |
| مشکل Rendering وجود دارد | محتوای اصلی در Screenshot یا Rendered HTML دیده نمیشود | JavaScript، API، منابع مسدود، SSR/CSR |
۱. URL هنوز توسط گوگل کشف نشده است
اولین احتمال این است که گوگل هنوز از وجود URL خبر ندارد. اگر URL در هیچ لینک داخلی، Sitemap یا مسیر قابلخزش دیگری وجود نداشته باشد، ممکن است گوگل دیرتر آن را پیدا کند یا اصلاً کشف نکند.
برای بررسی این حالت:
- مطمئن شوید صفحه از صفحات مرتبط لینک داخلی گرفته است.
- بررسی کنید URL داخل Sitemap XML قرار دارد.
- مطمئن شوید لینکها با تگ
<a href>قابلخزش ساخته شدهاند. - عمق کلیک صفحه را بررسی کنید؛ صفحه مهم نباید چندین کلیک از صفحه اصلی فاصله داشته باشد.
- در صورت تازه بودن صفحه، چند روز زمان بدهید و سپس با URL Inspection بررسی کنید.
اگر صفحه مهم است اما فقط در Sitemap قرار دارد و هیچ لینک داخلی به آن نمیرسد، سیگنال اهمیت آن برای گوگل ضعیف است. Sitemap کمک میکند، اما جای معماری لینک داخلی را نمیگیرد.
۲. صفحه در وضعیت Discovered – currently not indexed مانده است
این وضعیت یعنی گوگل URL را میشناسد، اما هنوز آن را Crawl نکرده یا پردازش کامل آن انجام نشده است. در این حالت، مشکل معمولاً قبل از مرحله Crawl رخ داده است.
دلایل رایج:
- صفحه لینک داخلی کافی ندارد.
- در Sitemap تعداد زیادی URL کمارزش وجود دارد.
- سایت URLهای پارامتری یا فیلترهای زیادی تولید میکند.
- سرور کند یا ناپایدار است.
- صفحه تازه منتشر شده و هنوز نوبت Crawl آن نرسیده است.
در این وضعیت، فقط Request Indexing زدن کافی نیست. ابتدا باید بفهمید چرا گوگل هنوز صفحه را در اولویت Crawl قرار نداده است.
۳. صفحه Crawled شده اما ایندکس نشده است
در وضعیت Crawled – currently not indexed گوگل حداقل یک بار صفحه را Crawl کرده، اما فعلاً آن را وارد ایندکس نکرده است. اینجا معمولاً باید بعد از دسترسی فنی، سراغ ارزش صفحه بروید.
موارد مهم برای بررسی:
- آیا صفحه پاسخ مستقل و کامل به یک نیاز جستوجویی میدهد؟
- آیا با صفحات دیگر سایت بسیار مشابه است؟
- آیا Canonical به خودش اشاره میکند؟
- آیا Google-selected canonical همان URL مورد انتظار شماست؟
- آیا صفحه شبیه Soft 404 یا صفحه کممحتواست؟
- آیا محتوای اصلی در نسخه Rendered HTML دیده میشود؟
اگر گوگل صفحه را دیده اما آن را نگه نداشته، معمولاً باید کیفیت، تمایز، Canonical و رندر صفحه را جدیتر بررسی کنید.
۴. صفحه noindex دارد
یکی از مستقیمترین دلایل ایندکس نشدن صفحه، وجود دستور noindex است. این دستور ممکن است در HTML صفحه یا در هدر HTTP ارسال شود.
نمونه Meta Robots:
<meta name="robots" content="noindex, follow">نمونه X-Robots-Tag:
X-Robots-Tag: noindexبرای بررسی این مورد:
- سورس HTML صفحه را ببینید.
- هدرهای HTTP را بررسی کنید.
- تنظیمات افزونه سئو، قالب و CMS را کنترل کنید.
- در URL Inspection بخش Indexing allowed را بررسی کنید.

۵. robots.txt مسیر صفحه را مسدود کرده است
فایل robots.txt برای کنترل Crawl استفاده میشود، نه برای حذف مطمئن صفحه از ایندکس. اگر مسیر صفحه در robots.txt بسته شده باشد، Googlebot ممکن است نتواند محتوای صفحه و دستورهای داخل آن را ببیند.
نمونه مسدودسازی:
User-agent: *
Disallow: /private/
اگر صفحهای را میخواهید از ایندکس خارج کنید، در بیشتر موارد noindex روش مستقیمتری است. اما برای اینکه گوگل noindex را ببیند، باید بتواند صفحه را Crawl کند. ترکیب نادرست robots.txt و noindex میتواند باعث سردرگمی شود.
۶. Canonical به URL دیگری اشاره میکند
گاهی صفحه از نظر فنی سالم است، اما گوگل URL دیگری را بهعنوان نسخه اصلی انتخاب میکند. در این حالت ممکن است شما فکر کنید صفحه ایندکس نشده، در حالی که گوگل آن را نسخه فرعی یا Duplicate یک صفحه دیگر تشخیص داده است.
در URL Inspection دو بخش را بررسی کنید:
- User-declared canonical
- Google-selected canonical
اگر این دو متفاوت باشند، باید سیگنالهای Canonical را بررسی کنید:
- تگ canonical صفحه
- URLهای داخل Sitemap
- لینکهای داخلی
- ریدایرکتها
- شباهت محتوایی بین URLها
Canonical یک سیگنال قوی است، اما دستور قطعی نیست. اگر لینک داخلی، Sitemap و محتوا با Canonical هماهنگ نباشند، گوگل ممکن است نسخه دیگری را انتخاب کند.
۷. صفحه Duplicate یا بسیار مشابه است
اگر چند صفحه محتوای بسیار مشابه داشته باشند، گوگل معمولاً نیازی نمیبیند همه آنها را جداگانه در ایندکس اصلی نگه دارد. این موضوع در سایتهای فروشگاهی، صفحات فیلتر، صفحات شهر و مقالات تکراری زیاد دیده میشود.
نمونههای رایج Duplicate یا Near Duplicate:
- صفحات محصول با توضیحات کپیشده از تولیدکننده
- صفحات دستهبندی با محتوای تقریباً یکسان
- صفحات شهر با متن مشابه و فقط تغییر نام شهر
- URLهای پارامتری مثل رنگ، سایز و مرتبسازی
- مقالات مشابه با تغییرات جزئی در عنوان
راهحل همیشه حذف صفحه نیست. گاهی باید محتوا را متمایز کنید، گاهی Canonical تنظیم کنید، گاهی لینک داخلی را اصلاح کنید و گاهی باید اجازه ندهید URLهای کمارزش قابلخزش باشند.
۸. صفحه Soft 404 تشخیص داده شده است
Soft 404 یعنی صفحه از نظر فنی پاسخ 200 میدهد، اما محتوای آن شبیه صفحه خطا، صفحه خالی یا صفحه بدون ارزش واقعی است. برای مثال، صفحه دستهبندی بدون محصول یا صفحه محصول حذفشده که هنوز با پیام «موردی یافت نشد» باز میشود، میتواند Soft 404 تشخیص داده شود.
برای بررسی Soft 404:
- مطمئن شوید صفحه محتوای واقعی و مفید دارد.
- اگر صفحه حذف شده، پاسخ مناسب مثل 404 یا 410 بدهید.
- اگر جایگزین دقیق دارد، ریدایرکت مرتبط ایجاد کنید.
- صفحات خالی دستهبندی، Tag و فیلتر را مدیریت کنید.
۹. محتوای اصلی در Rendering دیده نمیشود
در سایتهای JavaScript محور، ممکن است HTML اولیه تقریباً خالی باشد و محتوای اصلی بعد از اجرای JavaScript ساخته شود. گوگل میتواند بسیاری از صفحات JavaScript را Render کند، اما این به معنی بیاهمیت بودن معماری رندر نیست.
مشکلات رایج Rendering:
- خطای JavaScript
- خطای API
- نیاز به Cookie، Login یا Local Storage
- مسدود بودن فایلهای JS یا CSS ضروری
- نمایش محتوا فقط بعد از کلیک یا تعامل کاربر
- تفاوت مهم بین نسخه موبایل و دسکتاپ
برای بررسی، در URL Inspection گزینه Test Live URL را اجرا کنید، سپس Screenshot و Rendered HTML را ببینید. اگر محتوای اصلی در نسخه رندرشده دیده نمیشود، باید مشکل فرانتاند یا تحویل محتوا را حل کنید.

در پروژههایی که صفحات مهم با JavaScript ساخته میشوند، فقط دیدن کد وضعیت 200 کافی نیست. تجربه ما این است که باید سه خروجی را کنار هم ببینید: HTML اولیه، Rendered HTML در URL Inspection و Screenshot نسخه رندرشده. اگر محتوای اصلی فقط در مرورگر کاربر دیده میشود اما در Rendered HTML گوگل نیست، مشکل شما «ایندکس» نیست؛ مشکل تحویل محتوا به Googlebot است.
۱۰. کیفیت محتوا یا ارزش مستقل صفحه کافی نیست
گاهی هیچ مانع فنی واضحی وجود ندارد، اما صفحه باز هم ایندکس نمیشود. در این حالت باید از خودتان بپرسید: آیا این صفحه واقعاً ارزش مستقل دارد؟ آیا اگر کاربر از گوگل وارد این صفحه شود، پاسخ کامل و مفیدی میگیرد؟
مواردی که احتمال ایندکس نشدن را بیشتر میکنند:
- محتوای بسیار کوتاه و عمومی
- محتوای کپی یا بازنویسی سطحی
- صفحات تولید انبوه با ساختار یکسان
- صفحات محصول بدون توضیحات، مشخصات و اطلاعات اختصاصی
- صفحات دستهبندی بدون متن، محصول کافی یا هدف جستوجویی مشخص
- مقالاتی که با intent کاربر هماهنگ نیستند
برای صفحات مهم، بهجای فشار آوردن با Request Indexing، ابتدا محتوا را تقویت کنید، لینک داخلی مرتبط بسازید، دادههای ساختاری مناسب اضافه کنید و مطمئن شوید صفحه به یک نیاز مشخص پاسخ میدهد.
۱۱. Sitemap یا لینک داخلی سیگنال اشتباه میدهد
Sitemap و لینک داخلی باید با هم هماهنگ باشند. اگر URL در Sitemap هست اما در سایت لینک داخلی ندارد، یا اگر Canonical به صفحه دیگری است اما همان URL داخل Sitemap مانده، گوگل سیگنالهای متناقض دریافت میکند.
یک Sitemap سالم معمولاً نباید شامل این موارد باشد:
- URLهای noindex
- صفحات 404 یا 410
- URLهای ریدایرکتشده
- URLهایی که canonical آنها به صفحه دیگری است
- صفحات جستوجوی داخلی
- URLهای پارامتری کمارزش
همچنین صفحات مهم باید از صفحات مرتبط لینک داخلی بگیرند. اگر صفحهای برای کسبوکار مهم است اما هیچ صفحه مهمی به آن لینک نمیدهد، نباید انتظار داشته باشید گوگل هم اهمیت آن را بهخوبی تشخیص دهد.
۱۲. صفحه تازه منتشر شده و هنوز زمان کافی نگذشته است
ایندکس شدن فوری تضمینشده نیست. حتی بعد از ارسال Sitemap یا Request Indexing، ممکن است چند روز طول بکشد تا گوگل صفحه را Crawl و Index کند. اگر صفحه تازه منتشر شده، ابتدا مطمئن شوید از نظر فنی سالم است و سپس کمی زمان بدهید.
اگر بعد از گذشت زمان منطقی هنوز صفحه ایندکس نشده، دوباره این موارد را بررسی کنید:
- URL در Sitemap هست؟
- لینک داخلی دارد؟
- noindex ندارد؟
- Canonical درست است؟
- محتوای اصلی در Rendered HTML دیده میشود؟
- صفحه ارزش مستقل دارد؟
مسیر پیشنهادی عیبیابی ایندکس نشدن صفحه
برای اینکه بین گزارشها سردرگم نشوید، این مسیر را بهترتیب اجرا کنید:
- در URL Inspection بررسی کنید صفحه واقعاً Index نشده یا فقط رتبه ندارد.
- وضعیت Page fetch، Crawl allowed و Indexing allowed را ببینید.
- کد وضعیت HTTP را بررسی کنید.
- robots.txt و noindex را کنترل کنید.
- User-declared canonical و Google-selected canonical را مقایسه کنید.
- Screenshot و Rendered HTML را بررسی کنید.
- صفحه را از نظر Duplicate، Soft 404 و کیفیت محتوا ارزیابی کنید.
- Sitemap و لینک داخلی را با Canonical هماهنگ کنید.
- بعد از اصلاح، Test Live URL و Request Indexing را اجرا کنید.
- چند روز بعد وضعیت را دوباره در Page Indexing و URL Inspection بررسی کنید.
چطور پالت به تحلیل ایندکس نشدن صفحات کمک میکند؟
اگر فقط یک یا دو URL ایندکس نشده دارید، بررسی دستی با URL Inspection کافی است. اما وقتی دهها یا صدها URL در وضعیتهای مختلف Page Indexing قرار میگیرند، مسئله اصلی اولویتبندی است.
برای مثال، یک صفحه خدماتی مهم که در وضعیت Crawled – currently not indexed است، اولویت بیشتری نسبت به یک صفحه Tag خالی دارد. پالت کمک میکند همین تفاوتها را سریعتر ببینید و وقت تیم فنی یا محتوایی را روی URLهای درست بگذارید.
چکلیست سریع بررسی ایندکس نشدن صفحات
| مرحله | سؤال کلیدی | ابزار بررسی |
|---|---|---|
| کشف URL | آیا گوگل URL را میشناسد؟ | Sitemap، لینک داخلی، URL Inspection |
| Crawl | آیا Googlebot میتواند صفحه را دریافت کند؟ | URL Inspection، robots.txt، Crawl Stats |
| Indexability | آیا مانعی مثل noindex یا Canonical وجود دارد؟ | URL Inspection، HTML، HTTP Headers |
| Rendering | آیا محتوای اصلی بعد از Render دیده میشود؟ | Screenshot، Rendered HTML، Test Live URL |
| کیفیت | آیا صفحه ارزش مستقل و پاسخ کامل دارد؟ | بررسی محتوا، مقایسه با صفحات مشابه، intent analysis |
پرسشهای رایج
آیا Request Indexing باعث ایندکس فوری صفحه میشود؟
نه. Request Indexing فقط درخواست بررسی است. اگر صفحه noindex، Canonical اشتباه، محتوای ضعیف، مشکل Rendering یا Duplicate داشته باشد، درخواست ایندکس بهتنهایی کافی نیست.
آیا باید همه صفحات سایت ایندکس شوند؟
نه. بسیاری از URLها نباید ایندکس شوند؛ مثل صفحات فیلتر کمارزش، پنل کاربری، نتایج جستوجوی داخلی، صفحات تکراری یا صفحات noindex. هدف، ایندکس شدن صفحات مهم و canonical است.
چرا صفحه در Sitemap هست اما ایندکس نمیشود؟
Sitemap تضمین ایندکس نیست. اگر صفحه لینک داخلی ضعیف، noindex، Canonical متفاوت، محتوای تکراری، مشکل Rendering یا کیفیت پایین داشته باشد، ممکن است با وجود حضور در Sitemap ایندکس نشود.
چرا گوگل صفحه را Crawl کرده اما ایندکس نکرده است؟
در این حالت باید کیفیت محتوا، تمایز صفحه، Canonical، Soft 404، Duplicate Content و نسخه Rendered HTML را بررسی کنید. گوگل ممکن است صفحه را دیده باشد اما آن را برای نگهداری در ایندکس مناسب نداند.
ایندکس نشدن صفحه تازه منتشر شده طبیعی است؟
بله، تا حدی طبیعی است. ایندکس شدن ممکن است زمان ببرد. اما اگر بعد از چند روز یا چند هفته همچنان وضعیت تغییری نکرد، باید مسیر فنی، محتوایی و لینک داخلی را بررسی کنید.
جمعبندی
ایندکس نشدن صفحات سایت همیشه به یک علت ساده محدود نمیشود. ممکن است مشکل از کشف URL، Crawl، noindex، robots.txt، Canonical، Duplicate Content، Soft 404، Rendering، Sitemap، لینک داخلی یا کیفیت محتوا باشد.
برای عیبیابی درست، از URL Inspection شروع کنید و مرحلهبهمرحله جلو بروید. اول مطمئن شوید گوگل URL را میشناسد، بعد بررسی کنید میتواند آن را Crawl کند، سپس Indexability، Canonical، Render و ارزش محتوا را ارزیابی کنید.
مهمترین نکته این است که هدف شما نباید ایندکس شدن همه URLهای سایت باشد. هدف درست این است که صفحات مهم، مفید، قابلخزش، قابلرندر و canonical سایت در ایندکس گوگل حضور داشته باشند. برای سایتهایی با URLهای زیاد، پالت کمک میکند همین مسیر بررسی را سریعتر، منظمتر و اولویتبندیشدهتر انجام دهید.